同一份活、同一个模型,账单能差一个数量级。差价不在平台——官方价目表对所有人一样——在三个开关:什么时候调、缓存命中多少、输出占多大比例。这篇把账逐项算给你看。
先把结论摆出来:贵不在单价,在请求结构。
不是平台在坑你,也不是充值档位的问题。同一个 deepseek-flash,同样是 30000 token 的输入,你和我付的钱可能差 7 倍以上。
差别在这三个开关上,每一个都能自己拧。
01 官方价目表长这样
按 2026 年 11 月 3 日的官方定价页(单位:美元 / 百万 token):
- 输入·缓存未命中:闲时 $0.15,峰时 $0.30
- 输入·缓存命中:闲时 $0.003,峰时 $0.006
- 输出:闲时 $0.60,峰时 $1.20
- 上下文 1M,最大输出 384K
看这三个数就够了:峰时翻倍,输出 4 倍,缓存 2%。
单位是「百万 token」,看着吓人,其实一次普通对话也就几千 token。记住这三句,后面的账都能自己算。
02 开关一:把活挪到闲时
官方对「峰时」的定义很窄:北京时间工作日 9:00–12:00、14:00–18:00。
其余时间全是闲时,周末和节假日全天都算。
也就是说,同一批任务挪到晚上跑,挪个时间,账单减半,别的什么都不用改。
哪些任务适合挪:
- 批量摘要、报表生成、数据清洗这类异步活
- 爬虫抓完统一处理的内容
- 不着急要结果的翻译、转录
只有实时对话没法挪。其余的,先看能不能排到闲时,这是三颗开关里最省事的一颗。
顺带说一句,节假日是按中国法定节假日算的,不是按服务器时区。春节那几天全天闲时,排期可以大胆往前放。
03 开关二:让前缀命中缓存
缓存命中 $0.003,只有 2%。
问题来了:为什么大部分人的命中率低?因为他们的请求前缀每次都不一样。
Agent 类工具(Claude Code、Cursor、各类 CLI 助手)天然容易命中:系统提示词、工具定义、历史对话,这些内容每轮都重复。
三个能立刻做的动作:
- 固定 system prompt,别每次微调措辞
- 把不变的内容放最前面,变动的需求放最后
- 别在开头塞时间戳、随机 ID,一个变量能让整段前缀作废
前缀越长,命中收益越大。前缀 10 万,命中一次抵几十次。
想确认自己命中多少,看接口返回的 usage:里面会分别给出命中与未命中的 token 数。命中率低于 50%,说明前缀没整理好。
04 开关三:控制输出占比
输出 $0.60,是输入的 4 倍,这条最容易被忽略。
同一个任务,让模型「分析完直接给结论」,和让它「先复述一遍原文再分析」,成本能差出一截。
按贵到便宜排:
- 最贵:生成完整长文、逐字翻译、逐段改写
- 中间:结构化提取、多轮推理
- 最便宜:分类、打标、判断对错
不是让你少用模型,是别让它把已经有的东西再吐一遍。
05 三个开关叠加:同一任务,两种账单
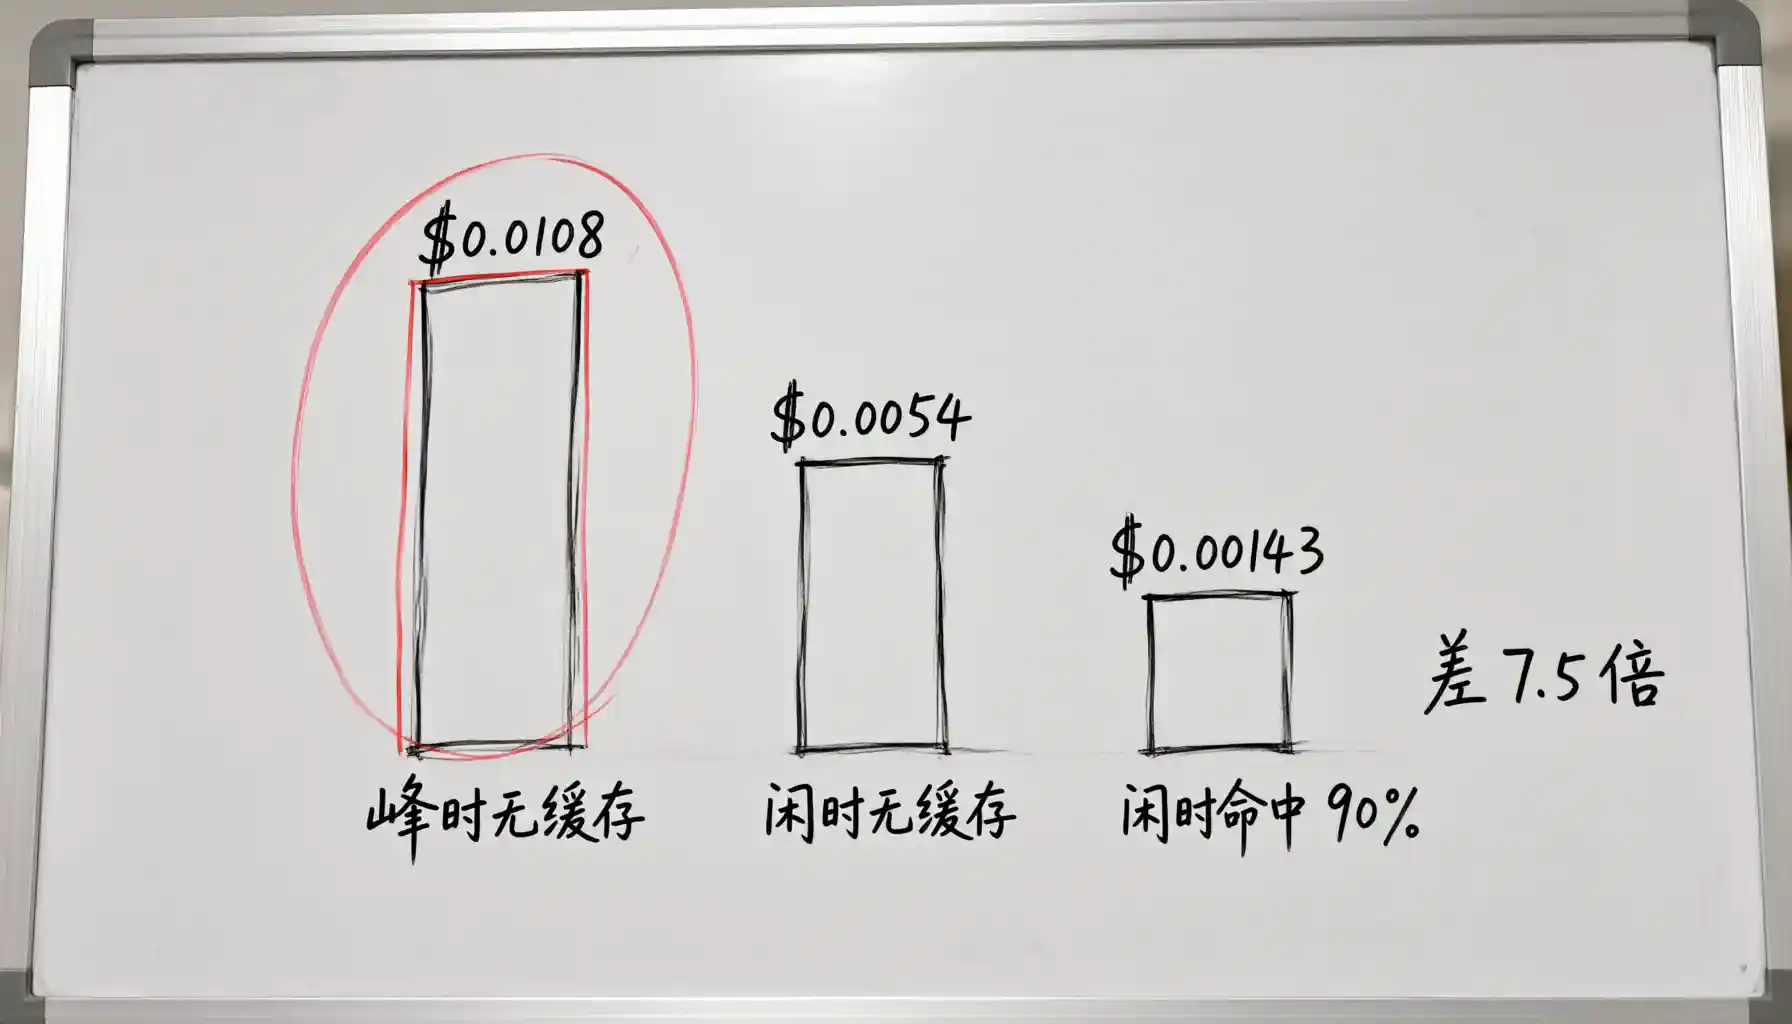
拿一个真实的请求结构算:输入 30000 token(其中 27000 是固定前缀),输出 1500 token。
| 配置 | 输入成本 | 输出成本 | 合计 |
|---|---|---|---|
| 峰时 · 无缓存 | $0.0090 | $0.0018 | $0.0108 |
| 闲时 · 无缓存 | $0.0045 | $0.0009 | $0.0054 |
| 闲时 · 前缀 90% 命中 | $0.00053 | $0.0009 | $0.00143 |
最贵和最省,差了 7.5 倍。
把前缀拉到 100000 token(同样 90% 命中),同样的任务差 11.9 倍。
前缀越长,缓存的价值越大——这也是为什么 Agent 工具的账单,比单次问答更能被优化。
反过来说,如果你的活天生就是输出密集型,比如批量改写、逐字翻译,三颗开关能救的空间有限。这时候该考虑换更小的模型,而不是在单价上死磕。
省钱的顺序不是找便宜的平台,是先把自己的请求结构捋顺。 —— 程序圆
最后
三颗开关,从易到难:
- 时段:改个排期就行,立刻减半
- 缓存:整理前缀,收益最大
- 输出比:要动产品设计,最难但最根本
先拧第一颗,今晚就能看到变化。
觉得有用?点个关注,后面继续拆 AI 工具的成本账。
