同一句提示词发下去,Claude 反问你「确定吗」,GPT 说「好的好的」,Gemini 回你三段带引用。有人把 12 个大模型各比成一个真人,我按「怎么用、别指望什么」重排成四组,顺手标出各自的致命缺点和该绕开的场景,你可以直接对号入座。
为了绕开各家模型的安全限制,一个开源仓库被刷到了 1.5 万星。
爱出海(@ai_chuhai)盯的是另一件事:不用急着绕,先搞明白每家的脑子怎么转。
他给 12 个大模型各配了一个真人:律师、工程师、外包团队、大学教授、酒吧哥们。
一句话结论:模型跟人一样有性格,你跟它吵架不是因为它蠢,是脾气没对上。
举个最日常的例子:同一份需求丢过去,好好先生照做,律师反问你,外包团队开始编。三次之后,你就知道该找谁了。
我按「怎么用、别指望什么」重排成四组,每组配一张画像卡。以下全部是他个人的使用观感,不是统一条件下的性能排名。
01 Claude:三种搭法,三种脾气
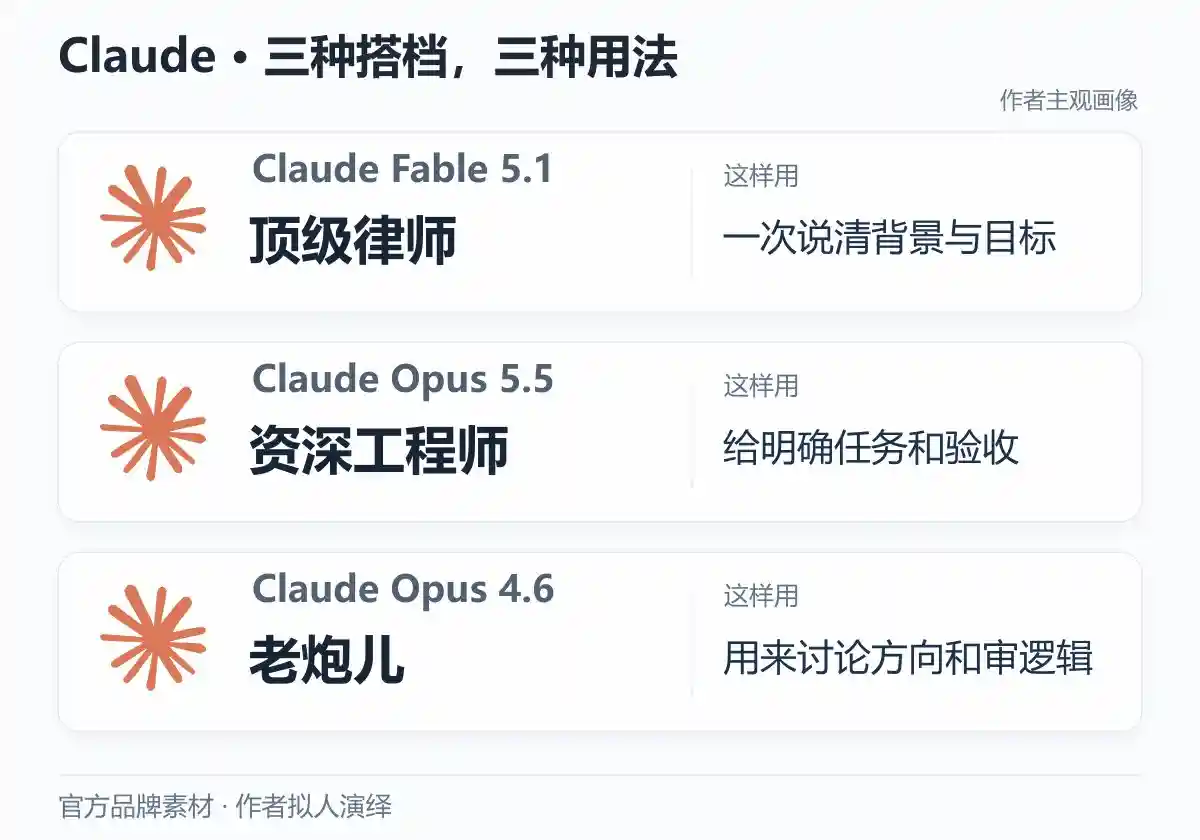
同一个厂,三个脾气差很远的产品。 搞混一次,你就得多花半小时重来。
你手上有个乱成一团的复杂案子:多份材料、互相矛盾的背景、没人说得清目标。这种活交给 Fable 5.1,它更像一位时薪两千的律师。逻辑严密,文件漂亮,路线自己规划。你只要把背景和目标一次性给全,然后忍住别改需求。它反问你「你确定吗」的时候,不是没听懂,是在说你说得不清楚。
日常最省心的是 Opus 5.5,像大厂干了十年的 P8。工单写得越具体,它干得越顺:把这个 API 对接完,写测试覆盖这三个场景。别跟它说「想点不一样的」,它不是不能,是每次想冒险,心里都有个小人喊「太危险」。创意你自己定,执行交给它。它还有个毛病是 AI 味重,写出来的段落你能闻到一股「我是 AI 我很安全」的味道。
Opus 4.6 适合放在顾问位。老江湖,手速不快,眼光毒,你抛一个观点它敢当场指出漏洞。但别让它干批量活:10 步的任务,它做到第 7 步觉得「差不多了」就交卷。
02 三家最常用的:好好先生、外包团队、大学教授
这三家是大多数人每天都在用的,用错性格的代价也最明显。
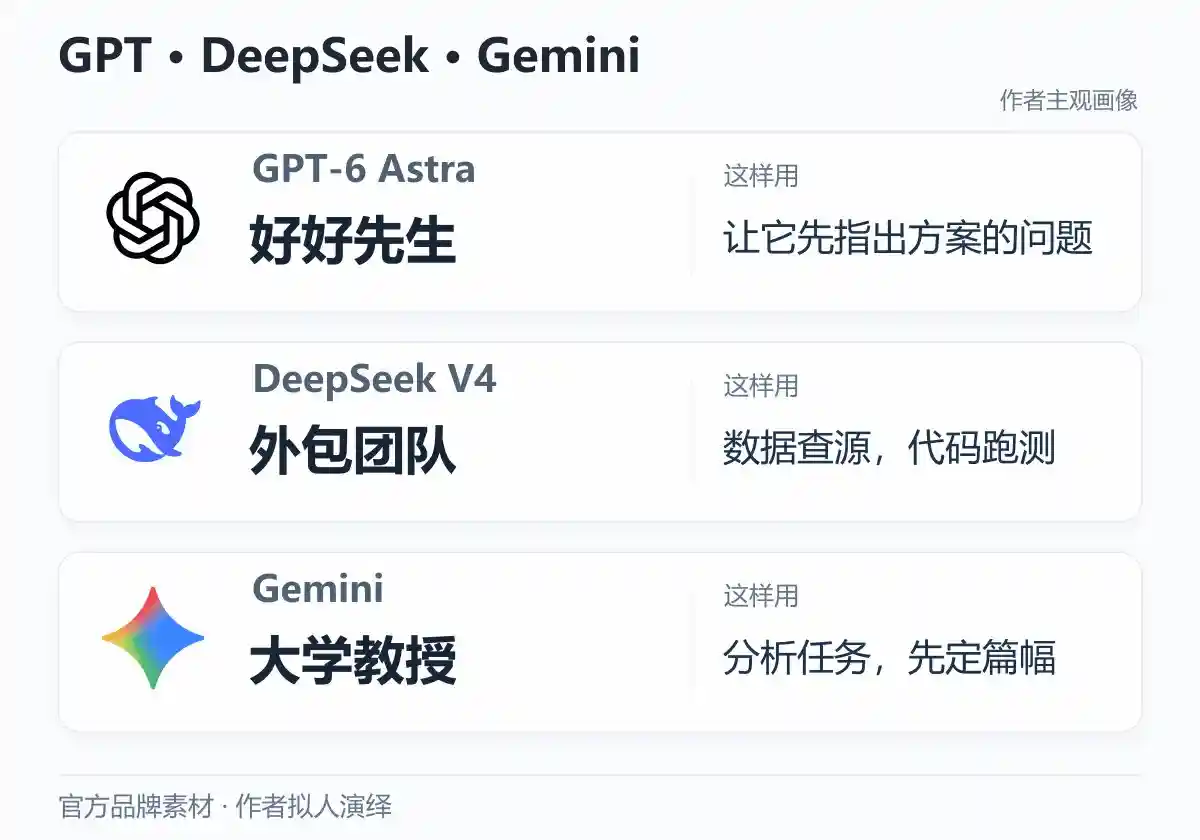
GPT-6 Astra 是好好先生。你说什么它都说好的,SOP 给足,代码工工整整,连注释都不偷懒。
问题也在这儿:你给一个有 bug 的方案,它会认认真真把这个 bug 实现出来,还加注释说明这个 bug 怎么工作。用法得倒过来——先让它挑方案的问题,再让它执行。它从不主动质疑你,你得逼它一次。
DeepSeek V4 是报价特别便宜的外包团队。写脚本、搭框架、做小工具,手速飞快,性价比很能打。
但它不肯说「我不知道」。宁可编一个听起来像那么回事的答案,也不轻易认怂:编引用、编数据、编 API 参数,而且编得特别像真的。
幻觉不是偶尔抽风,是稳定地、自信地编。所以把它当实习生管:数据查来源,代码跑测试,你要是把它当专家信,就会在一个虚构的事实上做决策。
Gemini 是大学教授。长上下文是它的强项,你让它从信息论角度拆一个系统,它能搬出 Kolmogorov 复杂度和 Shannon 熵,写得比论文好看。
你让它写三句话摘要,它给你三段带引用的论述。分析任务用它,聊天别用它,它写出来的社媒文案读着像教科书。
03 中文场景的三位:酒吧哥们、优等生、实习生
这三个我在中文活里都用得比较多,分工其实很清楚。
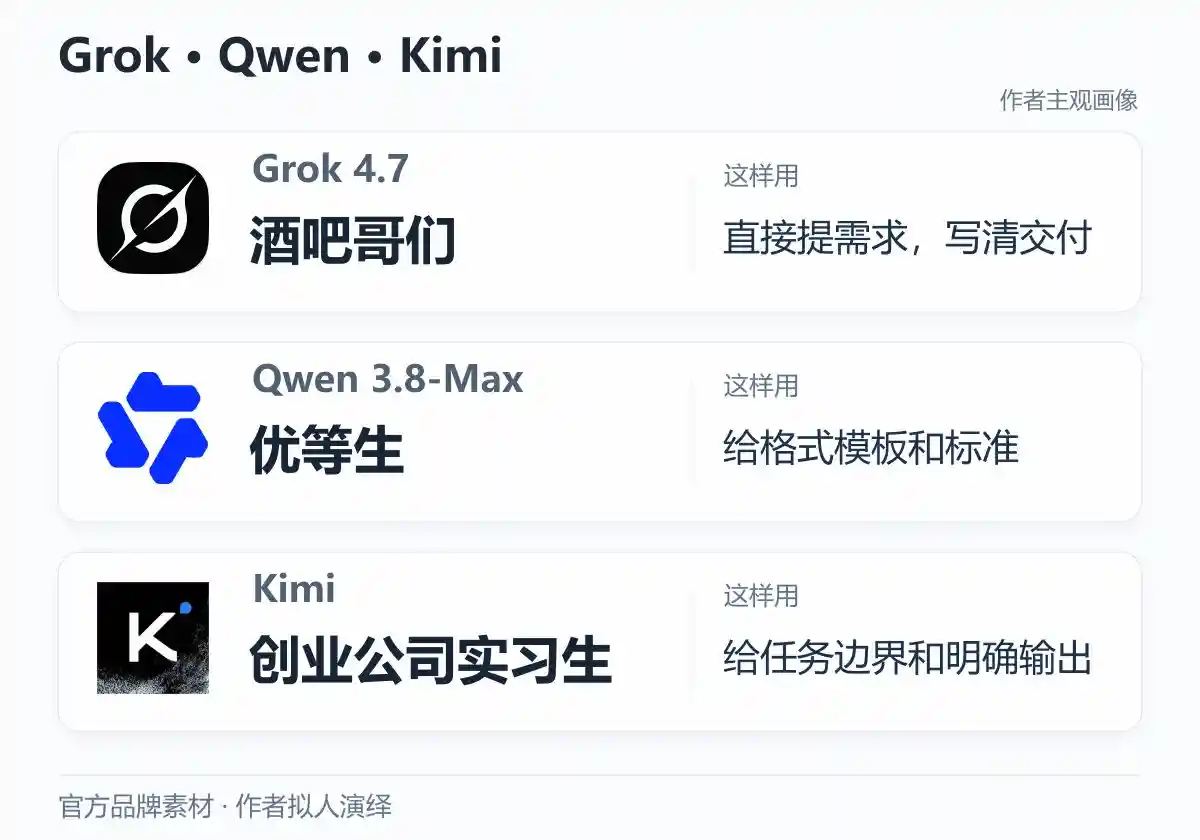
Grok 4.7 像一起喝酒的哥们。不装、不端着,你骂它回答垃圾,它不反思五分钟,直接改。
问 X 上的事它最顺手,本来就天然接着那份数据。轻量活、快查、起草,又快又便宜,深度推理别指望它。
Qwen3.8-Max 是班里常考前三、但你记不住名字的那个同学。解析 PDF、提取表格、整理数据,又快又准,中文文档处理是它的主场。
代价是没有锋利度。每个回答都中规中矩,像标准答案,你需要有人跟你掰扯策略的时候,找它没用。
Kimi 像创业公司实习生。长上下文和多步 agent 流程,我愿意交给它;架构决策别让它拍板。
它会给一个看起来合理的答案,但未必经得起推敲。执行型,不是思考型,给明确指令、要明确输出,它才不跑偏。
04 剩下三家:办事窗口、甩锅侠、毛坯房
这三家的问题不是能力,是边界。
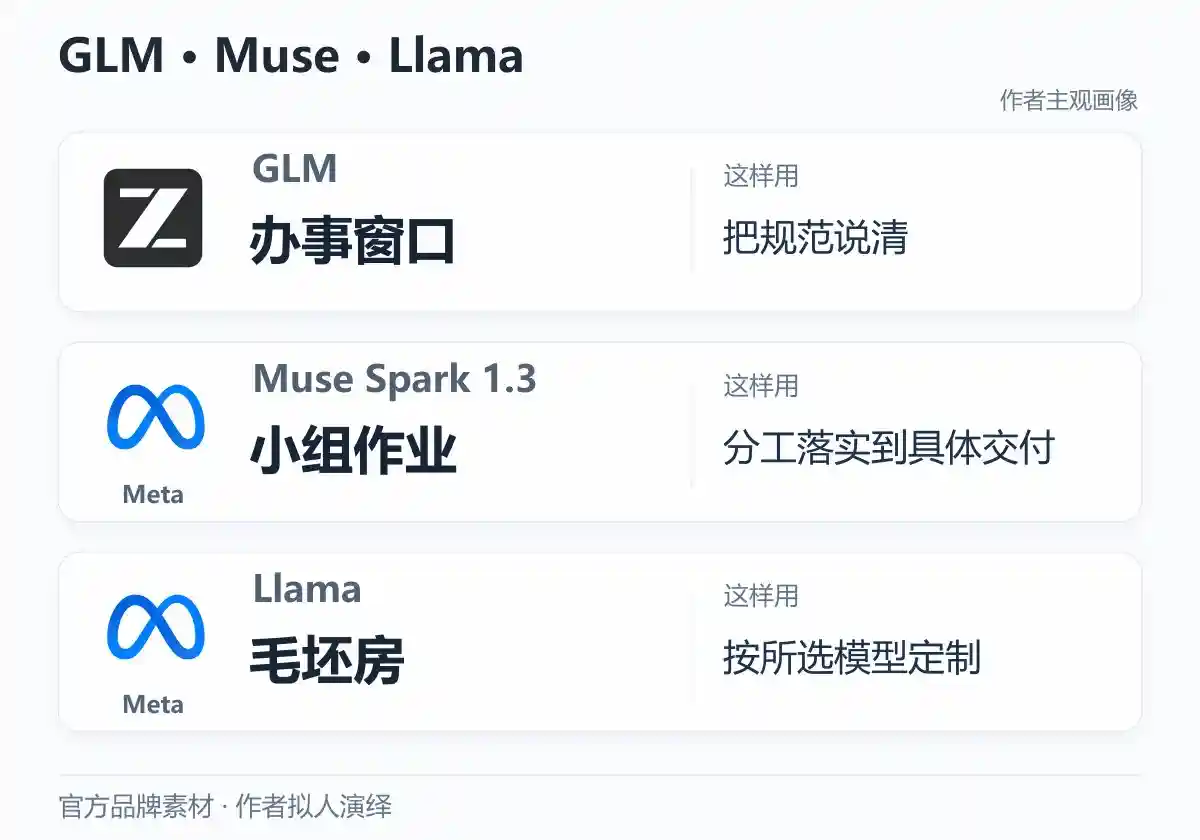
GLM 像政府办事窗口。给它格式模板和明确规范,它立刻顺手,一字一句按手册执行。
歧义是它最怕的东西。你说一句「帮我处理一下」,它能反过来问你八个问题才开始动。
Muse Spark 1.3 是小组作业里最会甩锅的那个。多模态、图片相关的活它能干。
一到 agent 模式就露馅:A 说这个该 B 做,B 说 A 已经做了,结果谁都没做。分工一多,最怕每个人都以为别人会收尾。
Llama 和开源系是毛坯房。它没有性格,因为性格取决于你怎么装修,喜欢什么讨厌什么都取决于你的 fine-tune。
有能力微调,它给你很大的自由;没有,它就是一面墙。而且就算装修得再好,层高就那样。自己部署开源的隐性成本——显卡、调参、运维——往往比 API 账单贵得多。
05 换了几家,毛病就这四个
看得越多越觉得,各家的问题其实是同一批:
- 跳步骤:觉得自己懂了,中间几步就省了
- 不敢判断:该给结论的时候,反过来问你「你想怎么做」
- 编数据:没有的事,编一个看起来像真的
- 废话太多:三句话能说完的,写三段
想自己验一遍也不难:挑一个你熟的旧项目,把同一段需求连问三家,看谁先反问你、谁直接开写、谁在编参数。三个回合下来,画像基本就出来了,比你翻十篇评测有用。
所以选模型这件事,先别看榜单,先看你让它干什么。
要执行,找工程师型;要判断,找顾问型;要便宜的批量活,找外包型。用错性格,再强的模型也难用。
下次它答得不好,先别急着说它笨,先想想你是在用什么脾气跟它说话。
你不会因为一个人内向就说他蠢,也不会因为一个直性子说话难听就说他坏。模型也一样。 —— 爱出海(@ai_chuhai)
觉得有用?点个关注,后面继续拆各家模型的脾气和用法。
参考:@ai_chuhai 的长文,2026-11-09 发布于 X。文中人物比喻均为原作者的主观使用观感,不是统一条件下的性能排名。
